探索と予測の違い
AlphaGoの開発に関わった研究者は、現在の大規模言語モデルに、2016年に囲碁システムがトップ棋士イ・セドル氏を破った際と同じ種類の推論能力を認めるべきではないと論じた。著者によると、この違いは重要だ。科学や医療で信頼できる応用を実現するには、もっともらしい並びを生成するだけでなく、取り得る行動を試し、その結果を評価できるシステムが必要だからだ。
AlphaGoは、相互に補完する二つの仕組みを組み合わせていた。方策ネットワークが有望な人間の指し手に似た着手を提案し、探索システムがその先の着手と応手の分岐を調べた。この二つ目の要素により、プログラムは目先のもっともらしさを超えて結果を評価できた。可能な局面数が膨大に増え、総当たりの計算が不可能な囲碁では、この構造が特に重要だった。
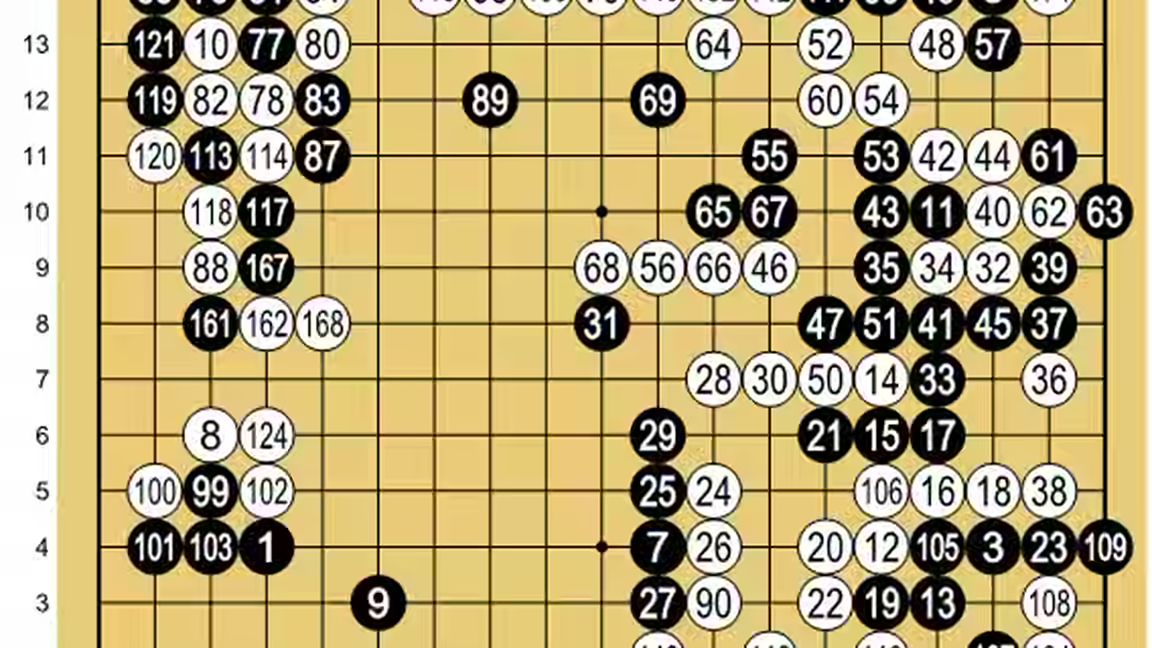
イ氏との第2局で有名になった37手目は、その違いを示している。方策の仕組みは、その手を強い人間の棋士が選ぶ可能性は極めて低いと評価した。AlphaGoがそれを選んだのは、探索処理がその後にあり得る展開をさらに先まで読み、異例の着手を有利と判断したためだ。システムはその対局に勝ち、5番勝負を4勝1敗で制した。
大規模言語モデルは異なる仕組みで動く。それまでの文脈を基に、次に来る可能性の高いトークンを繰り返し予測する。追加の技術で性能は改善でき、段階的に解いたように見える文章も生成できるが、記事の中心的な主張は、流暢な出力は、起こり得る未来を明示的な木構造にして組み立て、検証することと同じではないというものだ。
なぜこの違いが重要なのか
この比較は、素早い直感と、熟慮に基づく分析の違いに似ている。AlphaGoのネットワークは有望な選択肢を提示し、探索はその提案を吟味する構造化された方法を提供した。どちらか一方だけでは不十分だった。制限のない探索は計算負荷が大きすぎる一方、直感的な提案の仕組みだけでは決定的な一手を見逃していただろう。
言語モデルの開発者は、中間の手順を生成し、ツールを呼び出し、回答を検証するよう、システムを促す取り組みを強めている。これらの方法は出力をより役立つものにできるが、研究者は、熟考しているように見えることが、AlphaGoの探索に相当する基礎的な能力の証明になると考えないよう警告する。モデルは、一つ一つの推論を確実に検証しなくても、推論らしい言葉遣いを再現できる。
これは構造と信頼性についての議論であり、言語モデルに実用的な価値がないという主張ではない。情報を要約し、ソフトウェアを書き、解決策を提案する能力は大きな価値を持ち得る。懸念されるのは、他の可能性を探り、魅力的に見える誤りを排除する信頼できる仕組みがない場合に、重大な判断を担う利用者が、洗練された回答を過信してしまうことだ。
その意味で、AlphaGoの事例は10年後も重要であり続ける。その成果は、学習で得た直感と明示的な評価を組み合わせることで生まれた。答えの範囲が定まらない分野で同様に信頼できる結果を得るには、文章予測だけに頼るのではなく、両方の能力を統合したシステムが必要になるかもしれない。